近年、DX(デジタルトランスフォーメーション)の進展やAI活用の一般化に伴い、B2B企業においても「データ基盤」の整備が経営課題として語られる場面が増えていると言われています。一方で、データ基盤をめぐる会話には「DWH」「データレイク」「ETL」「MDM」「CDP」「SSOT」といった略語やカタカナ語が次々と登場し、部門をまたいだ議論がかみ合わないという声も多く聞かれます。
とりわけB2Bの現場では、マーケティング部門はCDPやMA、営業部門はSFAやCRM、情報システム部門はDWHやETLというように、それぞれが異なる用語体系で同じ「顧客データ」を扱っているケースが少なくありません。用語の意味と位置づけを共通言語として持つことが、データ基盤づくりの第一歩と考えられます。
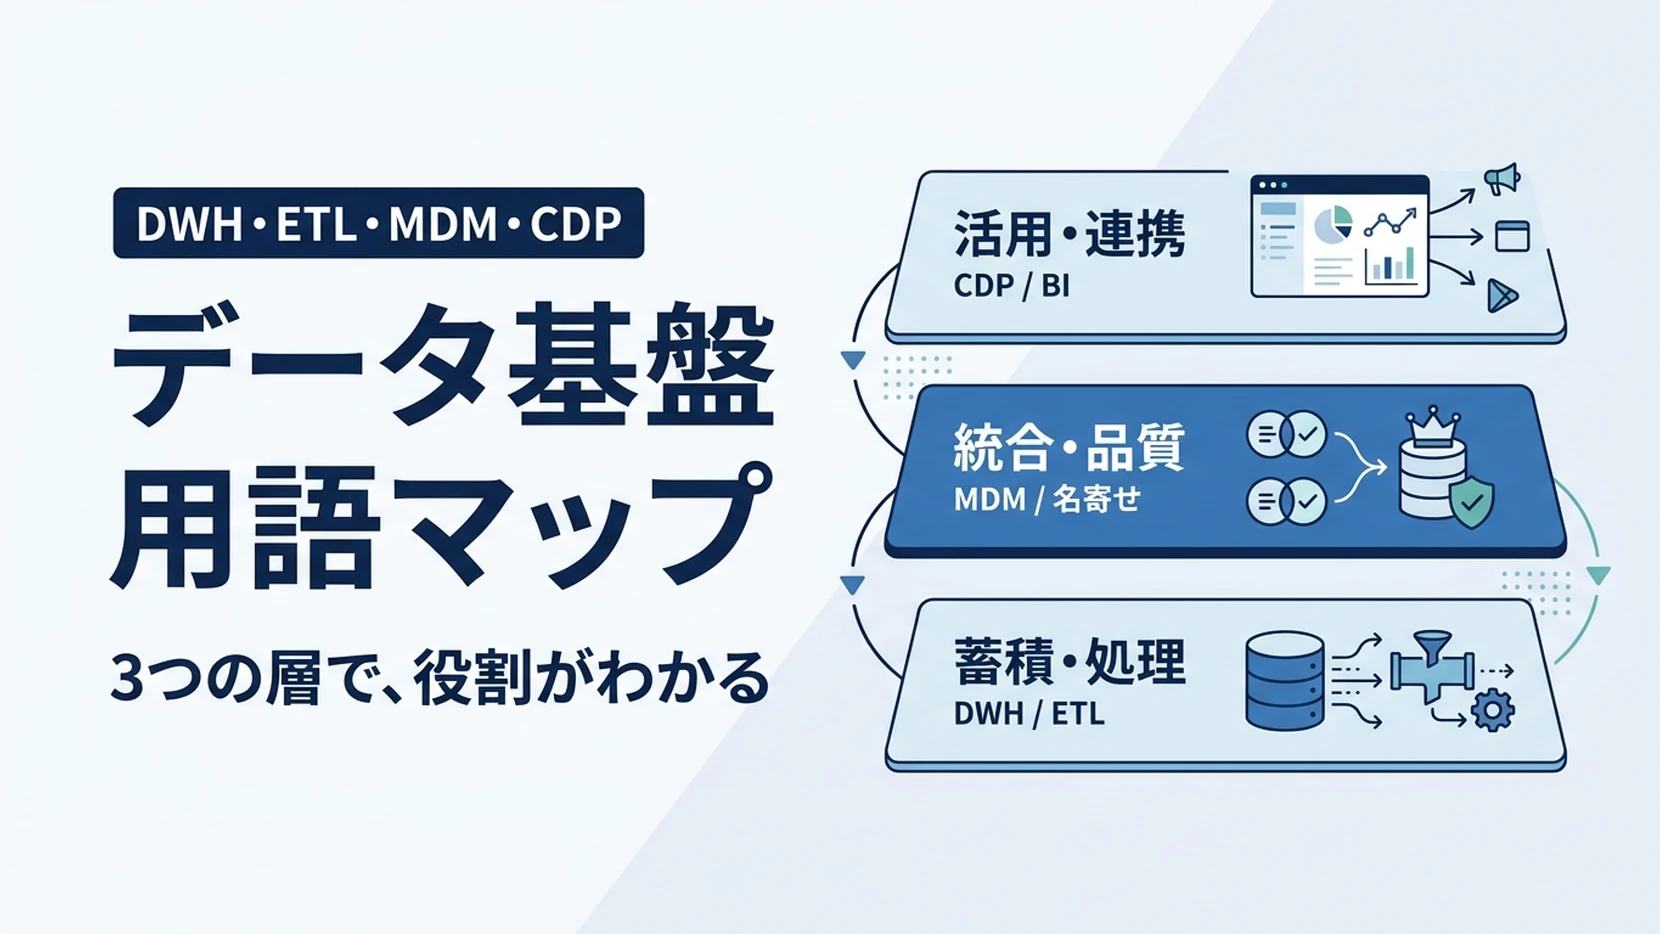
本記事では、B2B企業で使われがちなデータ基盤の用語を「蓄積・処理」「統合・品質」「活用・連携」の3つの層に分けた「データ基盤用語マップ」として整理し、それぞれの用語の意味と用法、そして用語マップを実務に落とし込むプロセスについて解説します。
データ基盤用語マップとは
「データ基盤用語マップ」とは、データ基盤を構成する技術・概念・ツールの用語を、データが流れる順序と役割に沿って地図のように配置した整理図のことです。個々の用語を暗記するのではなく、「どの用語がどの層に属し、隣接する用語とどのような関係にあるか」を把握することを目的としています。
弊社ではB2B企業の実務に照らし、データ基盤の用語を以下の3つの層に分けて捉えることを推奨しています。
- 蓄積・処理層(データを集めて流す層)
社内外のシステムからデータを取り出し、保管し、分析しやすい形に加工して流す領域です。データレイク、DWH、ETL、データパイプラインなど、情報システム部門が主に扱う用語が集まります。基盤の「土台」にあたる層と言えます。
- 統合・品質層(データを揃えて信頼できる状態にする層)
複数のシステムに散在するデータの重複や表記ゆれを解消し、組織として信頼できる「正」の状態を維持する領域です。名寄せ、データクレンジング、MDM、データガバナンスなどが該当します。B2Bにおいては企業データの整備が中心となるため、データ基盤の成否を左右する層と考えられます。
- 活用・連携層(データを業務で使う層)
整えられたデータをマーケティングや営業などの業務に届け、意思決定やアクションに繋げる領域です。CRM、SFA、MA、CDP、BIといった業務ツールに加え、外部から取得するサードパーティーデータやインテントデータもこの層に位置づけられます。
この3層の区分は厳密な技術分類ではなく、B2Bの実務で会話を成立させるための「見取り図」です。以降の章では、各層に属する用語を順に解説します。
蓄積・処理層の用語
蓄積・処理層は、データ基盤の議論で最初に登場することが多い用語群です。データの「置き場所」と「流し方」に関する用語が中心となります。
- データソース
データの発生元となるシステムやファイルのことです。B2Bでは基幹システム(ERP)、SFA、名刺管理ツール、Webサイトのアクセスログ、外部の企業情報データベースなどが代表的なデータソースに該当します。基盤設計では、まずどのデータソースが存在するかを棚卸しすることが出発点となります。
- データレイク
構造化・非構造化を問わず、生データをそのままの形式で大量に蓄積する保管領域です。「まず溜めておき、用途は後から決める」という思想で運用されることが多いと言われています。柔軟性が高い一方で、整理を怠ると使われないデータが堆積する「データスワンプ(沼)」化を招くリスクがあります。
- DWH(Data Warehouse)
分析用途に合わせて整形・構造化されたデータを蓄積する「データウェアハウス」のことです。データレイクが「原材料の倉庫」であるのに対し、DWHは「分析のために棚分けされた倉庫」と例えられます。特定部門向けに切り出した小規模なDWHは「データマート」と呼ばれ、近年はデータレイクとDWHの利点を併せ持つ「レイクハウス」というアーキテクチャも普及しつつあります。
- ETL(Extract/Transform/Load)/ELT
データソースからデータを抽出(Extract)し、変換(Transform)して保管先に格納(Load)する一連の処理です。クラウドDWHの処理能力向上により、先に格納してから変換する「ELT」という順序も一般化しています。B2Bの文脈では、SFAとMAの顧客データを共通形式に変換する処理などが典型的なETLの用法です。
- データパイプライン/データオーケストレーション
複数のETL処理や連携ジョブを、順序と依存関係を定めて自動的に流す仕組みを「データパイプライン」と呼びます。さらに、複数のパイプラインやツールを横断して全体の流れを統制・自動化する考え方が「データオーケストレーション」です。両者の詳細な違いや実現に必要な役割については、弊社ブログのデータオーケストレーションとは:データを一元的に利活用するで解説しています。
- データフェデレーション/データファブリック
データを1か所に物理的に集約せず、分散したまま仮想的に統一して参照する方式が「データフェデレーション」です。一方、「データファブリック」はフェデレーションやメタデータ管理などを組み合わせ、組織全体のデータを織物(ファブリック)のように結び付けるアーキテクチャ概念として使われます。それぞれデータフェデレーションとは:分散データを「統合」せずに「統一的」に利用する、企業情報の統合戦略における「データファブリック」の重要性で詳しくご紹介しています。
- API(Application Programming Interface)
システム同士がデータをやり取りするための接続口です。バッチ処理で夜間に一括連携するETLに対し、APIは必要なタイミングでリアルタイムに取得・更新できる点が特徴とされています。B2Bでは、CRMに登録された企業名をキーに外部データベースから最新の企業情報を即時取得する、といった用法が代表的です。
統合・品質層の用語
統合・品質層は、B2Bのデータ基盤において最も「現場の痛み」と結び付いた用語群です。蓄積・処理層をいくら整備しても、この層が機能していなければ、集まったデータは信頼して使えないと言われています。
- データのサイロ化
部門やシステムごとにデータが孤立し、横断的に利用できない状態を指します。営業のSFA、マーケティングのMA、経理の基幹システムにそれぞれ同じ取引先が異なる表記で登録されている、という状況が典型例です。サイロ化の構造と解消に向けた考え方は、データのサイロ化とは?名寄せで一元管理を実現する方法にまとめています。
- データクレンジング
表記ゆれ、欠損、誤入力、重複といったデータの「汚れ」を検出し、修正・除去する作業です。「株式会社」と「(株)」の混在、全角・半角の不統一、旧住所の残存などを整えることが該当します。混同されやすい「データクリーニング」との違いについては、データクレンジングとデータクリーニングの違いとは?をご参照ください。
- 名寄せ
複数のデータベースやレコードに分かれて存在する同一の企業・人物を、1つの実体として突合・統合する作業です。B2Bでは「社名の表記ゆれ」「本社と支店」「合併・社名変更」などにより同一企業が複数存在しやすく、名寄せの精度が営業効率や分析の正確さに直結します。弊社では名寄せとは?顧客データを整備・管理する方法を徹底解説!で具体的な手順と注意点を解説しています。
- マスターデータ/MDM(Master Data Management)
取引先、商品、拠点など、組織全体で共通して参照される基準となるデータが「マスターデータ」であり、これを一元的に定義・維持・配信する仕組みと活動が「MDM(マスターデータマネジメント)」です。クレンジングや名寄せが「整える作業」であるのに対し、MDMは「整った状態を維持し続ける仕組み」という位置づけになります。3つのアプローチの関係はデータのサイロ化を解消する3つのアプローチとは?クレンジング・名寄せ・MDMを解説!で整理しています。
- SSOT(Single Source of Truth)
組織内で「この情報が正である」と合意された唯一の参照元を指す概念です。MDMの目的を一言で表す用語として使われることが多く、「取引先の正式名称と法人番号はマスターを見る」というルールが浸透している状態がSSOTの実現例と言えます。SSOTが定まっていないと、会議のたびに「どの数字が正しいのか」という確認から始まることになります。
- データ品質
データが業務目的に対してどの程度「使える状態」にあるかを表す概念で、正確性、完全性、一貫性、鮮度、一意性などの観点で評価されます。AI活用の前提としてもデータ品質が重視されており、その背景はB2Bデータ活用に欠かせない「データ品質」の向上とはで解説しています。
- データガバナンス
データの定義、責任者、利用ルール、セキュリティ、品質基準などを組織として定め、守らせる統制活動です。MDMやデータ品質管理を「仕組み」とすれば、データガバナンスはそれらを支える「ルールと体制」にあたります。データオーナーやデータスチュワードといった役割の設置も、この用語の文脈で語られます。
- データカタログ/メタデータ/データリネージ
「メタデータ」はデータそのものを説明する情報(項目の意味、更新日、出所など)であり、それを検索可能な形で一覧化したものが「データカタログ」です。また、データがどのソースからどの処理を経て現在の形になったかという系譜を「データリネージ」と呼びます。これらは「そのデータは信頼してよいのか」を判断するための用語として、データガバナンスとセットで語られることが増えています。
- ダークデータ
収集・保管されているものの、活用されないまま眠っているデータのことです。名刺、過去の商談メモ、問い合わせ履歴などが該当し、B2Bでは貴重な顧客接点の情報が死蔵されているケースが少なくないと言われています。ダークデータの整備とDXの関係は【DXの本質 vol. 3】ダークデータの整備がDXを促進するでご紹介しています。
活用・連携層の用語
活用・連携層は、マーケティングや営業の担当者が日常的に接している用語群です。この層の用語は「ツール名」として語られることが多いため、それぞれの役割と、統合・品質層との接点を意識することが重要です。
- CRM/SFA/MA
「CRM(顧客関係管理)」は顧客との関係全体を管理する仕組み、「SFA(営業支援システム)」は商談や活動履歴を管理する営業向けツール、「MA(マーケティングオートメーション)」はリードの獲得・育成を自動化するマーケティング向けツールです。いずれも顧客データの重要なデータソースであると同時に、整備されたデータの活用先でもあります。3つのツールに同一企業が別々に登録されている状態が、前述したサイロ化の典型と言えます。
- CDP(Customer Data Platform)
複数のチャネルやツールから顧客データを収集・統合し、セグメント作成や施策への連携を行う「カスタマーデータプラットフォーム」です。MDMが「企業マスターの正しさ」を目的とするのに対し、CDPは「顧客ごとの行動データを束ねて施策に使うこと」を目的としており、両者は競合ではなく補完関係にあると考えられます。違いの整理は「MDM」と「CDP」の違いとは、選定の観点はMDM・CDPの選び方とは?をご参照ください。
- BI(Business Intelligence)
DWHなどに蓄積されたデータを可視化し、ダッシュボードやレポートとして意思決定に活用するためのツール群です。BIの画面に表示される数値の信頼性は、上流の統合・品質層に依存します。「ダッシュボードの数字が部門ごとに違う」という現象は、BIではなくSSOTの不在に原因があるケースが多いと言われています。
- ファーストパーティーデータ/サードパーティーデータ
自社が顧客との接点で直接取得したデータが「ファーストパーティーデータ」、外部の事業者が収集・提供するデータが「サードパーティーデータ」です。B2Bでは、自社のSFAやMAの情報だけでは企業の規模、業種、拠点、系列といった属性が揃わないため、外部の企業情報データベースをサードパーティーデータとして補完する用法が一般的です。
- インテントデータ
企業や担当者のWeb上の行動から「何に関心を持ち、検討段階にあるか」を推察するためのデータです。サードパーティーデータの一種として、自社との接点がまだない企業の「今」の関心を捉える用途で活用が広がっています。詳細はインテントデータとは?行動データから顧客の興味関心を可視化するで解説しています。
- 企業情報データベース/DaaS(Data as a Service)
法人番号、所在地、業種、従業員規模、系列関係などの企業属性を網羅的に整備したデータベースであり、B2Bにおける名寄せの「正解キー」や、市場規模の推定に用いられます。近年はこうしたデータをクラウド経由で継続的に提供する「DaaS(データ・アズ・ア・サービス)」という提供形態が定着しつつあります。構築の考え方は企業情報データベースの作り方、DaaSの概要は企業データ活用の新しい形・DaaS(データ・アズ・ア・サービス)とはでご紹介しています。
データ基盤用語マップを実務に落とし込むプロセス
用語マップは眺めて終わるものではなく、自社のデータ基盤の現状を診断し、投資の優先順位を決めるための道具として使うことで価値を発揮します。以下のプロセスで進めることが有効と考えられます。
- ステップ1:自社のデータソースを用語マップに配置する
ERP、SFA、MA、名刺管理、Webログ、外部データなど、社内に存在するデータソースを棚卸しし、3つの層のどこに位置するかを書き込みます。この時点で「どの層が空白か」が可視化されます。
- ステップ2:用語の定義を部門横断で揃える
「顧客」「取引先」「リード」「アカウント」といった基本用語が部門ごとに何を指しているかを確認し、共通定義を文書化します。データガバナンスの最初の成果物として、この用語集を位置づけることが推奨されます。
- ステップ3:統合・品質層のボトルネックを特定する
名寄せ率、重複件数、欠損率、更新からの経過日数などを簡易的に測定し、どの品質観点が最も業務に影響しているかを見極めます。多くのB2B企業では、蓄積・処理層より先にこの層への投資が効果を生むと言われています。
- ステップ4:統合キーとSSOTを定める
企業を一意に識別するキー(法人番号や外部データベースの企業コードなど)を決め、どのシステムのどの項目を「正」とするかを合意します。この統合キーの選定が、以降の名寄せとMDMの精度を大きく左右します。
- ステップ5:活用・連携層との接続を設計し、運用に乗せる
整備したマスターをCRM、MA、BIへ配信する経路をETLやAPIで設計し、更新頻度と責任者を定めて運用します。運用開始後も、用語マップを定期的に見直し、新しいツールや外部データを追加していくことが継続の鍵となります。
おわりに
本記事のポイントを3点にまとめます。①データ基盤用語マップとは、頻出する用語を蓄積・処理、統合・品質、活用・連携の3層で整理した共通言語、②B2Bでは部門ごとに用語体系が異なりサイロ化や品質低下が生じやすく、統合・品質層が成否を左右する、③自社のデータソースを地図に配置し統合キーとSSOTを定めることが、実務への落とし込みの出発点になる、という点です。
データ基盤をめぐる用語は数多く存在しますが、それぞれを「データがどこに置かれ、どう整えられ、どこで使われるか」という流れの中に位置づければ、部門をまたいだ議論の土台として機能します。特にB2Bにおいては、企業データの名寄せ・MDM・SSOTといった統合・品質層の用語を正しく理解し、統合キーの選定と外部データによる補完を早期に検討することが不可欠です。
弊社の顧客データ統合ソリューション「ユーソナー」は、本記事で解説した統合・品質層と活用・連携層をつなぐ役割を担うソリューションです。「LBC」という独自のコード体系による顧客情報の管理に加え、独自に収集した企業データを活用頂くことで、鮮度の高い外部情報を継続的に取得することが可能です。特定の情報については弊社が開発したAPIを用いることで、CRMやMAへよりリアルタイムに連携頂くこともできます。
詳細についてはぜひこちらのページから、お気軽にお問い合わせください。