- 名寄せ・データクレンジング
- 顧客管理・分析
部門最適から全社横断へ。RevOpsの課題を解く企業データ基盤とSnowflake
更新日: 2026年10月23日
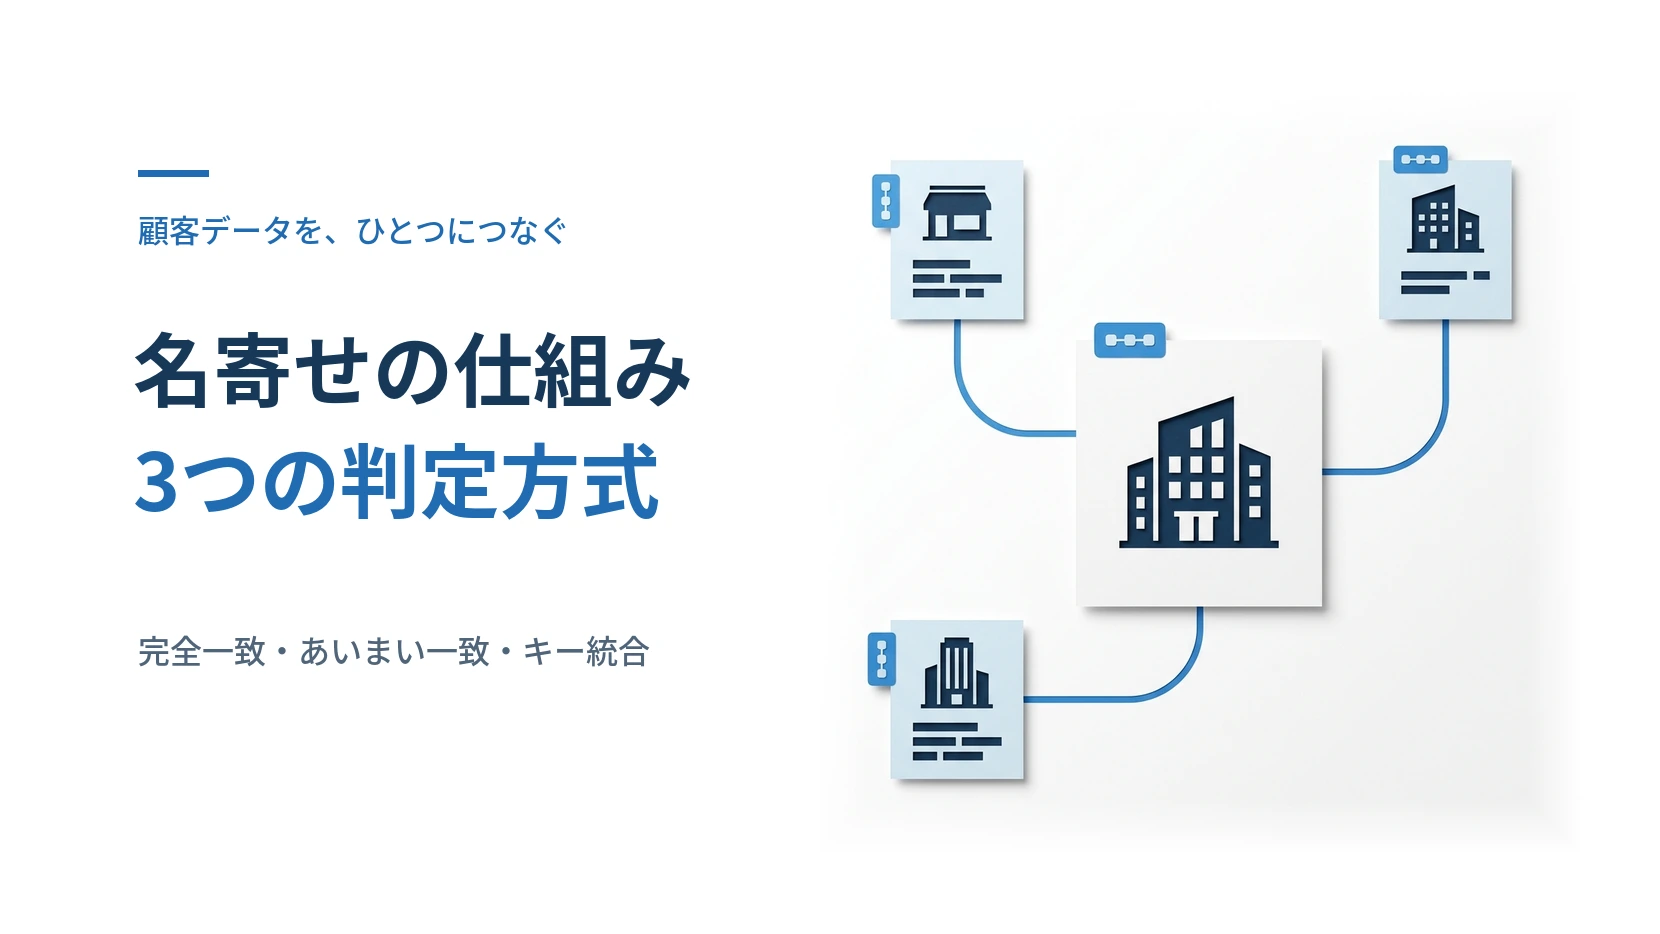
B2B企業の顧客データは、CRM(顧客関係管理システム)、SFA(営業支援システム)、MA(マーケティングオートメーション)、名刺管理ツール、基幹システムなど、複数のシステムに分散して蓄積されるのが一般的です。同じ取引先が「株式会社ABC」「ABC(株)」「エービーシー」といった異なる表記で別々に登録され、重複したまま放置されているケースは少なくないと言われています。
こうした重複を解消し、「同一の企業」「同一の人物」を1つにまとめる処理が「名寄せ」です。名寄せの重要性や基本的な進め方については、弊社ブログの「名寄せとは?顧客データを整備・管理する方法(https://usonar.co.jp/blog/5890.html)」でもご紹介しています。一方で、実際に名寄せを設計する段階になると「どの方式で同一かを判定するのか」という仕組みの部分でつまずくご担当者の方が多いのが実情です。
本記事では、名寄せの判定方式を「完全一致」「あいまい一致」という2つの既存アプローチに体系化した上で、そのいずれとも異なる第3の考え方としての「キー統合」について解説します。
目次
こちらの記事もおすすめ!
一般的に「完全一致」とは、比較対象となる項目の値が文字列として完全に同じである場合にのみ、同一のレコードとみなす判定方式を指します。
名寄せにおいて完全一致で判定を行うことは、ルールが明快で処理結果を説明しやすいという点で優れていると言われています。「メールアドレスが同一なら同一人物」「電話番号と社名が同一なら同一企業」というように、判定条件を業務担当者が理解できる言葉で定義できます。誤って別の企業を1つにまとめてしまう「過剰統合」のリスクが低く、処理も高速であるため、大量データを対象とした一次的な重複排除に向いています。
完全一致アプローチの主な特徴は以下の通りです。
具体例としては、メールアドレスや法人番号のように一意性が高く表記ゆれの少ない項目をキーにした個人名寄せや、データクレンジング後に正規化された社名・電話番号の突合が該当します。
一般的に「あいまい一致」とは、文字列が完全には一致しなくても、類似度が一定の基準を超えていれば同一のレコードとみなす判定方式を指します。編集距離やN-gram、音韻的な類似度といったアルゴリズムで2つの文字列の近さをスコア化し、しきい値を超えた組み合わせを候補として抽出します。
名寄せにおいてあいまい一致で判定を行うことで、人間が見れば同じ会社だと分かる表記ゆれを、システム側で自動的に吸収することが可能となります。「ユーソナー株式会社」と「ユーソナー(株)」、「山田太郎」と「山田 太郎」のような差異は、あいまい一致であれば同一候補として拾い上げることができます。
あいまい一致アプローチの主な特徴は以下の通りです。
具体例としては、Excelの関数や表計算ソフトで表記を整えた上で目視確認と組み合わせる手動名寄せや、CRM・SFAの重複管理機能における類似判定が挙げられます。段階的な名寄せの進め方については、弊社ブログの「名寄せの方法を5段階のレベルで解説」で詳しく整理しています。
「キー統合」とは、レコード同士の文字列を直接比較するのではなく、各レコードに対して外部の信頼できる基準(マスターデータ)を参照した一意の識別子である「名寄せキー」を付与し、そのキーの一致をもって同一と判定する考え方を指します。もともとはマスターデータマネジメント(MDM)の領域で用いられてきた発想であり、企業データにおいては法人番号や独自の企業コードがキーとして利用されます。
完全一致とあいまい一致はいずれも「手元にあるレコード同士を見比べる」方式ですが、キー統合は「それぞれのレコードを、外部の正解データに照らして同定する」という点で発想が異なります。文字列比較の精度に依存せず、システムをまたいだ突合や継続的な更新に強いことから、複数システムに顧客データが分断されたVUCA(不確実性、不安定性、複雑性、曖昧性)の時代において特に価値を提供する考え方だと言われています。
具体的には、以下のようなプロセスを経るとされています。
キー統合は、初回のマッチングに手間がかかる一方で、一度キーが付与された後は「キーの完全一致」という最も単純で確実な判定に帰着するため、運用フェーズにおいて強力なメソッドとなります。ただし、公的な法人番号は本店にのみ指定され、支店や事業所には付与されないという制約があります。この課題の詳細については、弊社ブログの「事業所データを活用した『法人番号』の付与」で解説しています。
「キー統合」は、単なる重複排除にとどまらず、分断されたデータを企業単位・グループ単位でつなぎ合わせる基盤として活用されています。B2Bマーケティングやセールスの領域においても、以下のような活用が期待できます。
キー統合の具体例
キー統合により、名寄せは「一度きりの整備作業」から「継続的にデータ品質を維持する仕組み」へと進化します。ただし、キーの付与精度は照合先となるマスターデータの網羅性と鮮度に依存するため、中小・零細企業や事業所単位まで含めた基準データをどう確保するかが実務上の論点となります。そのため、法人番号や自社の顧客コードに加えて、網羅性の高い企業情報データベースと併用することで、より高い付与率と精度が期待できます。
本記事のポイントを3点にまとめます。①名寄せの判定方式には、文字列を直接比較する完全一致・あいまい一致と、一意の識別子を付与して束ねるキー統合の3つがある、②完全一致は表記ゆれに弱く、あいまい一致はしきい値設計と過剰統合のリスクが課題となる、③キー統合を軸に据えれば運用フェーズの判定が単純化し、継続的なデータ品質の維持に繋がる、という点です。
本記事でご紹介したアプローチはいずれも有用です。完全一致アプローチは、ルールが明快で過剰統合のリスクが低い一方、表記ゆれの多い企業データでは統合漏れが発生しやすい方式です。あいまい一致アプローチは、表記ゆれを柔軟に吸収できる一方、しきい値の調整と目視確認の負荷が課題となります。キー統合は、この2つを照合の内部に組み込みながら、最終的な判定を「キーの一致」という確実な形に集約する考え方です。3つのアプローチを状況に応じて使い分け、時には組み合わせることが、精度と運用効率を両立した名寄せに繋がります。
弊社が提供する顧客データ統合ソリューション「ユーソナー」では、日本最大級の企業情報データベースを照合先として、お客様の顧客データに名寄せキーを付与する仕組みを提供しております。「LBC」という独自のコード体系による顧客情報の管理に加え、社名の表記ゆれや旧社名・統廃合といった過去情報のナレッジを活用した高精度なマッチング、本支店関係の紐付け、鮮度の高い外部情報の継続的な取得が可能です。
詳細についてはぜひこちらのページから、お気軽にお問い合わせください。
この記事を書いた人
ユーソナー編集部
MXグループ・編集長
ユーソナー編集部です。
主にBtoB事業を営む企業様に向け、これからの業務のあり方を考える上で有用なデータ活用やデジタル技術に関する情報を発信しています。
ユーソナーは業種・業界問わず
様々な企業において活用いただいております。

ITreview Grid Award 2026 Fall
リーダー認定6部門