- AI SaaS
- データ活用
生成AI・LLMの精度は「データ整備」で決まる?企業が取るべき4つのステップを解説!
更新日: 2026年10月26日
「ちゃっぴー、今期の売上と顧客数を教えて?」
質問に対してAIが即座に回答。でも、返ってきた数字が、社内レポートと合わない。。
そんなときは、質問の仕方だけでなく、何を売上と呼び、どの企業を顧客として数えているかを確認したいところです。
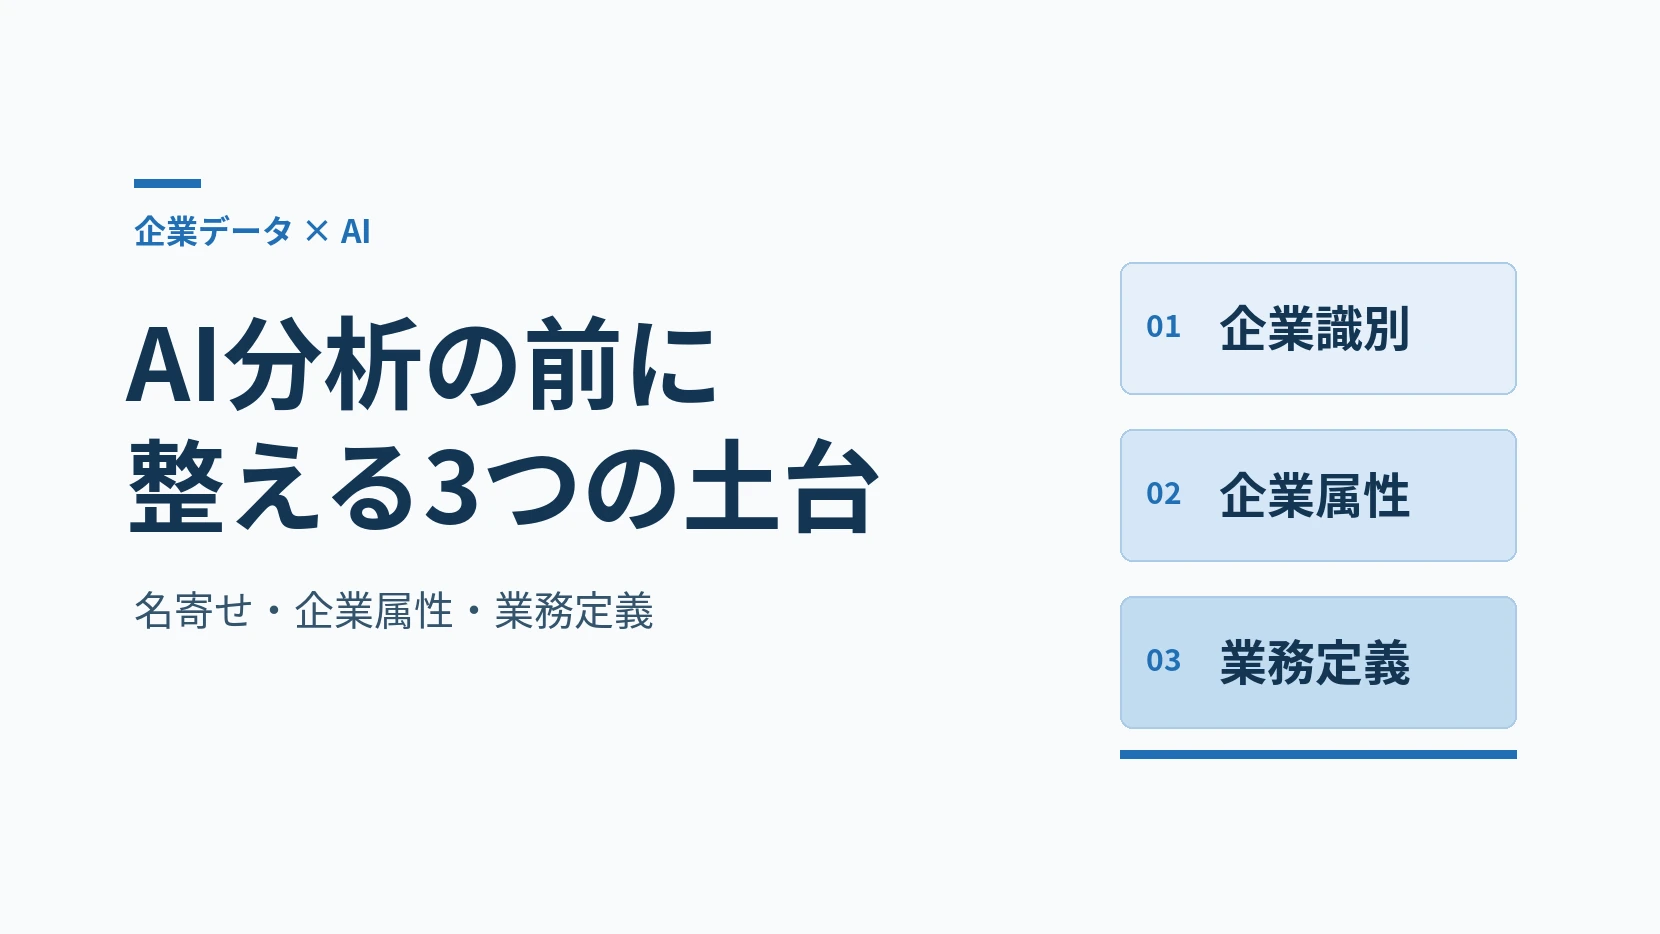
企業データを使うAI分析には、「どの企業の情報か」「どんな企業か」「何をどの条件で数えるか」という3つの土台があります。名寄せ、企業属性の補完、業務定義は、それぞれ別の役割を担います。
MicrosoftとSnowflakeの公式技術資料を手がかりに、3つの役割と、Snowflakeのセマンティックレイヤーを解説します。部門別の活用例から、自社で答えたい問いを小さく検証する方法まで整理します。
目次
こちらの記事もおすすめ!
例えば、営業会議では受注額を、月次決算では売上計上額を見ている場合、同じ「売上」という言葉でも参照すべきデータは異なります。AIの回答を確認するときも、金額だけを比べるのではなく、使った項目・日付・集計条件までたどる必要があります。
では、こうした業務上の意味をAIにどう伝えるのでしょうか。MicrosoftとSnowflakeの公式資料から、具体的な仕組みを見ていきます。
MicrosoftのPower BI向け公式資料は、AIに組織固有の用語や業務ロジック、分析ルールを伝える「AI instructions」を説明しています。資料中の販売モデルの例では、売上という質問には指定のNet Salesを使い、その金額は値引き・返品を反映し、取消注文を除くといった条件を示しています。日付の基準や会計年度、顧客を識別する項目も、説明の対象です。※1
これは、ある企業の売上が改善したという事例ではなく、AIが参照するモデルに業務上の意味を伝えるための設定例です。参考になるのは、「売上」のような日常語でも、参照する項目と計算条件を明確にする必要があるという点です。利用者に毎回長い指示を書いてもらう前に、繰り返し使う意味をモデル側で共有する方法を考えます。
Snowflakeの公式資料では、Semantic Viewsを、業務上の指標や対象、データ同士の関係を定義し、物理的なデータに業務上の意味を加える仕組みとして説明しています。例えば、値引き後の売上を共通の計算式として定義すれば、レポートや分析ごとに計算方法が分かれることを抑える設計につながります。※2
両社の機能は同一ではありませんが、業務で使う言葉と、データの項目・計算を対応させる考え方は、自社の準備にも参考になります。ただし、説明を設定すれば必ず正解になるわけではありません。Microsoftも、AI instructionsは非構造化のガイダンスであり、AIが完全に従う保証はないと明記しています。※1
また、指標の意味がそろっても、企業の取り違えや業種の欠損が直るわけではありません。数字の定義と、分析対象となる企業データの整備を、別々に点検する必要があります。
同じ会社なのに、名刺では正式名称、CRMでは略称、MAでは英字表記。取引データには支店名まで付いている。
こうした状態では、企業ごとの接点や取引が分かれて見えることがあります。
名寄せは、表記の違いなどを確かめ、同じ対象を指す情報を結び付ける作業です。全角・半角、「株式会社」と略記、旧社名、英字とカナ、旧字体・異体字、拠点名の併記などを扱います。ただし、文字をそろえれば解決するわけではありません。同じ社名の別法人もあれば、よく似た名前の無関係な会社もあります。名前の一致だけでまとめると、別の企業の売上や行動を結び付けるおそれがあります。
そのため、所在地なども確認し、法人・事業所・企業グループの関係を残します。元のシステムの顧客コードも保持し、共通の企業識別情報との対応をたどれるようにします。判断があいまいな候補は、無理に確定せず確認対象に分けることが大切です。
例えば、本社の担当者が資料をダウンロードし、支店の担当者がセミナーに参加し、別部署の担当者と営業が名刺交換したとします。これは考え方を説明する仮の例です。一人ずつ見れば別の接点ですが、企業単位で見ると、複数の部署と関係ができていることが分かります。
一方、親会社と子会社は別法人です。グループとして関係を眺める場合も、契約や売上を無条件に一社へ統合してはいけません。企業コードの付与は、同一人物の特定とも別です。
「企業としてまとめる」「拠点別に残す」「グループとして眺める」を使い分けることが、企業データを分析に使う出発点です。
名寄せの評価でも、結び付いた割合だけでなく、サンプルの正誤、未確定データ、集計結果の整合性を確認します。
企業名と行動履歴があれば、「どの会社が何をしたか」は確認できます。しかし「製造業の中堅企業から反応が増えたか」と聞くには、業種と企業規模の情報が必要です。AIに問いを工夫しても、比較するためのデータがなければ、根拠のある答えは出せません。
ここで役立つのが、信頼できる外部企業データとの照合・補完です。ユーソナーの法人企業データベース「LBC」は、企業の業務内容・規模・業種などの情報を扱い、名寄せや情報付与に活用する仕組みです。※3 企業属性を加える意義は、項目を増やすこと自体ではなく、判断に必要な比較軸を持てることにあります。
| 保有データだけで確認しやすいこと | 企業属性と結び付けて検証したいこと |
|---|---|
| 資料ダウンロードの総件数 | 狙っている業種・企業規模からの反応か。 |
| 広告経由の獲得件数 | 受注につながる企業層を獲得しているか。受注データとの連携も必要。 |
| セミナー参加者数 | 重点市場の何社と接点を持てたか。市場母数と対象企業の定義も必要。 |
| Web閲覧の増減 | どの業種の関心が変化したか。企業識別できる範囲に限り、未識別分も明示。 |
属性を補う際は、出典、更新時点、実測値か推定値かを確認します。従業員数も単体と連結では意味が違い、業種分類が違えば比較対象が変わります。取得できない項目は不明のまま残し、不明分を除いた分析であることを示します。AIに無根拠に埋めさせると、分析の材料そのものに誤りを持ち込むことになります。
業種や規模が分かっても、購入意欲や予算が分かるわけではありません。属性は、問いを具体化して比較するための情報です。相手の意思や次の行動は、別の情報と合わせて確かめます。
受注額、請求額、売上計上額は、同じ金額とは限りません。受注した月とサービスを提供した月が違う場合、どの日付で集計するかによっても、月次の数字は変わります。返品、取消、返金、値引きをどの指標にどう反映するかも、先に決める必要があります。
顧客数も同じです。契約のある法人数、当月に購入した法人数、サービスを利用中の事業所数では、示している状況が違います。同じ企業に複数契約がある場合、契約数を足しても企業数にはなりません。名寄せで企業が特定できても、どの状態を顧客と呼ぶかは業務側の判断です。
例えば「月間購入企業数」を、対象月に有効な購入実績がある法人の重複を除いた数と定義します。取消注文を除外し、返品や返金は別途定めたルールで扱い、既存顧客と初回購入企業を分ける。これは説明用の仮の定義であり、自社の販売モデルや会計・営業の目的に合わせ、関係部門で合意する必要があります。
項目の意味を説明する一覧が「データ辞書」です。ただ「日付」「金額」と書くだけでなく、受注日・請求日・売上計上日のどれなのか、税抜か税込かといった業務上の意味も残します。次の項目を整理すると、担当者にもAIにも、使う条件を伝えやすくなります。
| 項目 | 説明する内容 |
|---|---|
| 意味 | 何の業務イベントを表すか。 |
| 単位 | 件・人・事業所・企業・グループのどれか。 |
| 対象 | 含める条件、除外する条件。新規・既存、更新・追加購入の区別。 |
| 時間 | 使う日付、期間、タイムゾーン、更新時点。 |
| 集計 | 重複、取消、失注、返金、欠損を指標ごとにどう扱うか。 |
| 管理 | 誰が承認し、定義変更を誰が更新するか。 |
こうした業務上の意味を、データを使う側と保存されたデータの間で共有する層を、一般にセマンティックレイヤーと呼びます。難しく聞こえますが、「この会社で売上と言ったら、どのデータをどの式で集計するか」を共通の定義として扱うための考え方です。
Snowflakeでは、その役割を担う仕組みの一つがSemantic Views(セマンティックビュー)です。公式資料では、顧客や注文などの業務上の対象とその関係、集計する指標、分析の切り口などを定義すると説明しています。指標は売上合計などの計算、切り口は地域や商品カテゴリなどの分類です。※2
例えば、注文データと顧客データの対応関係、値引き後の売上の計算、業種別に比較する切り口をあらかじめ整理します。すると「業種別の売上は」と質問するときに、どの顧客情報と金額を使うかを、その都度解釈し直すことを減らせます。Snowflakeの公式資料は、Cortex AgentsがSemantic Viewの定義を読み、物理テーブルに対するSQLを生成する仕組みも説明しています。※2
ただし、意味を定義する層があっても、別会社の取引を誤って結び付けていたり、業種が欠けていたりすれば、その問題は残ります。
名寄せで「どの企業か」を整理し、企業属性で「どう比較するか」を補い、セマンティックレイヤーで「どの意味・計算・関係を使うか」を共有する。
役割を分けて組み合わせることが重要です。定義や結合が適切か、AIが生成した処理と答えが妥当かは、引き続き確認します。
ルールは文章で渡すだけでなく、指標の計算式や分析用データモデルにも反映し、同じ条件を再利用できるようにします。データ同士を結ぶ際は、企業と契約、契約と明細がそれぞれ一対一なのか一対多なのかも確認します。売上明細に複数の接点履歴を直接結合すると、同じ売上が複数行に現れることがあるためです。
MicrosoftのFabric data agent向け資料も、生成されたDAXという集計式を確認し、質問に正しく答えているかを検証するよう説明しています。※4 AIが作った式やクエリをデータベースなどで実行する構成では、計算をモデルの暗算と混同せず、参照先、絞り込み、結合、集計条件を点検します。
名寄せは対象の整理、属性補完は比較軸の充実、業務定義は数字の意味と計算条件の整理です。
企業識別の軸や項目説明の形式は共通化しやすい一方、有効商談、新規顧客、売上計上、広告の評価期間などは、自社の業務に合わせて決める必要があります。
企業を共通の軸として捉えられると、マーケティングの集計から、会社全体の判断へ問いを広げられます。
以下は必要なデータの連携と定義を前提にした活用例です。特定企業の導入実績や、特定製品の標準搭載機能を示すものではありません。
「従業員数が増えている企業群のうち、自社の接点や取引が少ないのはどこか」。時点を比較できる企業属性に、接点履歴、契約・売上・利益、自社の提供対象条件を組み合わせれば、重点市場や人員配置、商品別の展開先を検討する材料になります。
ただし、従業員数の増加だけで需要や予算は断定できません。属性の取得方法や定義が変わっていないかも確認し、候補市場の顧客に課題を聞くなど、需要の検証につなげます。
「獲得単価は安いのに、商談や受注につながりにくい企業層はどこか」。自社の広告費・流入・獲得履歴と、企業属性、商談・受注情報を結び付けます。業種や規模ごとに比較すれば、配信対象、資料、訴求、チャネル別予算を見直す候補が具体的になります。
ここで必要なのは、自社広告の費用と成果のログです。顧客企業の広告出稿状況は別のデータであり、それだけで自社広告の投資対効果が分かるわけではありません。受注までの期間差も考慮して比較します。
「関心の変化が観測され、自社Webへの来訪もあるのに、最近接触していない企業はどこか」。企業に結び付いたインテントデータ、自社Web閲覧、CRMの接触履歴、企業属性を使い、再接触の優先候補と、確認したいテーマを整理します。
インテントデータは、閲覧などから企業の関心を捉えるための情報で、購入意思の確定情報ではありません。Webの企業識別も、閲覧した人物の特定とは別です。観測範囲や更新頻度を確かめ、理由を確認する営業活動につなげます。
「発表後に、重点業界の企業からの閲覧や資料参照は増えたか」。発信日、記事やテーマ、識別可能なWeb訪問、企業属性、ほかの施策の履歴を合わせれば、次回の発信テーマや配信先、営業との連動を考える材料になります。
ただし、識別できた訪問だけで読者全体を代表させないことが重要です。発表前後の増減だけで広報の効果とも断定せず、広告、イベント、季節性なども確認します。
「利用が減っている顧客のうち、更新時期が近いのはどこか。追加導入を検討している顧客とは分けられるか」。契約区分、更新日、相談履歴、サービス利用・操作ログ、企業属性を組み合わせ、更新前の支援と追加提案の候補を整理します。契約単位の動きと企業全体の利用状況も分けて見ます。
操作回数が少ないという理由だけで、不満や解約意思を決め付けないようにします。ログの欠落や利用形態の違いを確かめ、必要に応じて顧客の状況を直接確認します。
「取引先と関係する企業群のうち、名刺接点はあるが取引のない企業はどこか」。企業・グループ関係に、取引履歴と名刺の担当者・部署情報を結び付けると、既存関係を踏まえた開拓順序を考えられます。
グループ関係があることと、紹介してもらえること、決裁が共通であることは別です。関係の基準日や取引対象の範囲を確認し、担当者と相談して進めます。同じ企業の情報として検討できても、閲覧範囲は役割と利用目的に合わせて設計します。
AIに「どの業種で成果が出ているか」と聞くときも、何を成果と呼ぶかを決める必要があります。
受注企業数を増やしたいのか、商談から受注への転換を見たいのか。同じデータでも、件数と率では読み取れることが違います。
以下は考え方を説明する仮の数値です。比較期間と商談の観察期間をそろえ、各法人を1回だけ数えます。商談対象企業のうち、その期間内に受注した企業の割合を受注率とします。
| 区分 | 商談対象企業 | 受注企業 | 受注率 |
|---|---|---|---|
| 業種A | 1,000社 | 100社 | 10% |
| 業種B | 100社 | 30社 | 30% |
受注企業数は業種Aの方が多く、受注率は業種Bの方が高くなります。だからといって、直ちに業種Bへ予算を移すとは限りません。市場の母数、売上・利益、商談期間、営業工数、失注理由も判断材料です。まだ受注結果が出ていない商談が多い業種と、十分に追跡できた業種をそのまま比べないことも大切です。
「業種Bの受注率が高い」は観測、「特定商品の需要に合っているのでは」は解釈、「対象企業を増やして提案する」は施策です。そして実施後に何が変わったかが、効果の検証になります。前後の差だけで因果が確定するわけではありません。
出力の確認では、期間と分母、結合による行の増加、不明・未識別分を除いた影響を点検します。見つかった差が偶然や顧客構成の違いで説明できないかも考えます。データを整えていても、AIの推論や集計式、結合条件に誤りは起こり得ます。施策を変える前に、何をどの期間で測るかを決めておきましょう。
全社のデータ刷新が終わるまで、試せないわけではありません。まずは「どの企業層に広告予算を配分すべきか」など、判断したい問いを一つに絞ります。次の順序なら、不足している部分と、その整備が判断にどう役立ったかを確認しやすくなります。
評価は、合意した定義との一致、分析できる範囲、業務負担、意思決定への役立ち方、施策後の事業成果を分けます。企業識別率や属性の付与状況には不明分も併記し、紐づけの正しさはサンプルで確かめます。「回答が速かった」だけでなく、「根拠を確認した回答まで、どれだけ時間がかかったか」を見ると、運用上の価値を考えやすくなります。
運用では、データの意味を決める業務責任者、結び付け方や集計を整える担当者、結果を判断する利用部門の役割を明確にします。更新日、変更履歴、回答の根拠、閲覧範囲も残します。全社横断で使うことは、全社員に全情報を開放することではありません。必要なデータと権限から、無理のない範囲で始めます。
こうした企業データの役割を、営業やマーケティングだけでなく、経営企画やカスタマーサクセスなど、複数の業務を支える土台として捉えるのが「法人データインフラ」という考え方です。
企業情報を集めて保管するだけでなく、部門やシステムに分かれた情報を同じ企業に結び付け、必要な属性とともに、分析や判断に使える状態へ整えます。
AI活用でも、この土台と、業務上の意味を定義するセマンティックレイヤーは異なる役割を担います。法人データインフラで「どの企業の、どのような情報か」を支え、セマンティックレイヤーで「何を、どの条件で集計するか」を共有する。両方を組み合わせることで、企業データを自社の問いに沿って活用しやすくなります。
ユーソナーは、LBCを辞書として使い、法人顧客やリードの名寄せ・クレンジング、項目の補完、古い情報の更新に活用する仕組みを提供しています。本社・支社などの関係を踏まえた情報の整理も、その一つです。※3
企業データ分析での役割は、社内で別々に登録されていた企業の情報を結び、業種や規模などの比較軸を補うことです。接点の件数だけでなく、どの企業層と関係を持てているかを考えるための材料になります。ただし、必要な属性の有無や対象企業への付与状況、更新時点、利用条件は、用途に合わせて確認が必要です。
そして「有効商談とは何か」「更新と追加購入をどう分けるか」は、自社が決める仕事として残ります。外部企業データを取り入れることと、自社の業務定義を整えることを、どちらか一方で代替することはできません。
Snowflake上で企業データのAI活用を検討する際も、企業を特定するデータと、Semantic Viewsなどで扱う業務の意味付けを分けて設計します。Snowflakeの機能説明は、特定のユーソナー製品への標準実装を示すものではありません。利用環境、接続方法、データの利用条件、設定・運用の担当範囲を確認して進めます。
企業を正しく結び、必要な属性を補い、自社の数字の意味をそろえる。その組み合わせが、AIに聞ける問いと、判断に使える分析の範囲を広げます。
目指すのは、AIに答えを任せ切ることではなく、人が根拠を確かめて次の行動を決められる状態です。
まずは、次の会議で判断したい問いを一つ選んでみてください。その問いに答えるために足りないのは、企業の特定なのか、比較する属性なのか、集計の定義なのか。小さく切り分ければ、関係部門と決めること、企業データで補えること、分析後に検証することが具体的になります。
自社の企業データを分析に使える状態へ整えたい方は、現在のデータと、答えたい問いをもとにユーソナーへご相談ください。
出典
※1 Microsoft「Prepare your data for AI - AI instructions」
※2 Snowflake「Overview of semantic views」
※3 ユーソナー「各システム間のデータ統合を実現する名寄せとは」(2026年10月26日内容確認)
※4 Microsoft「Semantic model best practices for data agent」
この記事を書いた人
ユーソナー編集部
MXグループ・編集長
ユーソナー編集部です。
主にBtoB事業を営む企業様に向け、これからの業務のあり方を考える上で有用なデータ活用やデジタル技術に関する情報を発信しています。
ユーソナーは業種・業界問わず
様々な企業において活用いただいております。

ITreview Grid Award 2026 Fall
リーダー認定6部門